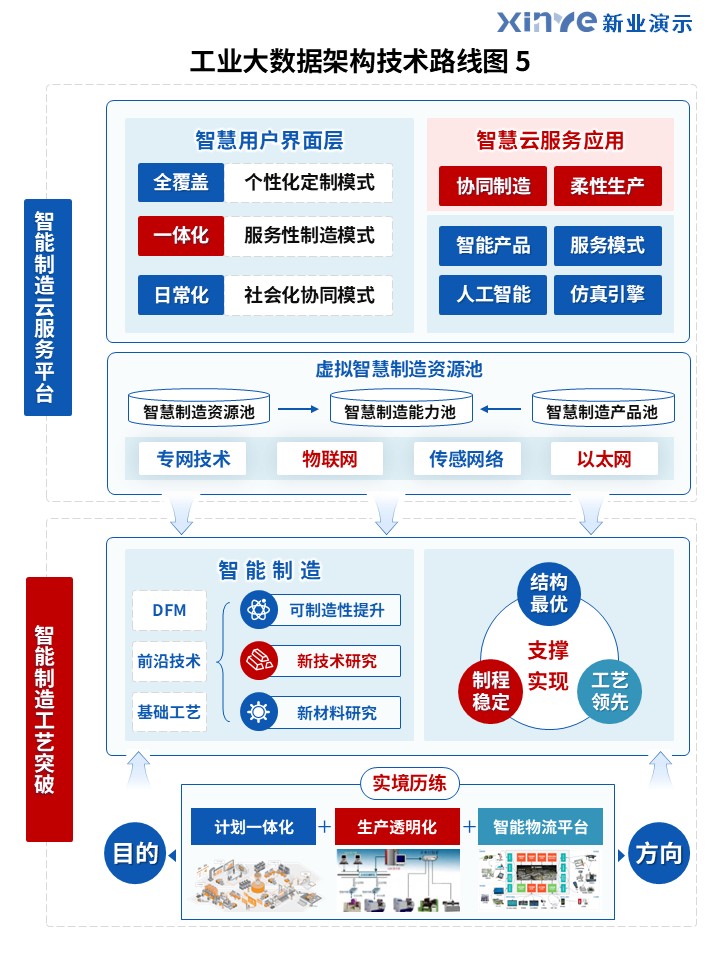
案例背景
工业大数据架构需要把研究对象、数据来源、处理方法和验证结果组织成可追踪的研究链。本案例重点说明设备、工艺和质量数据如何完成采集、治理、计算并支持业务决策,并以数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间作为结果核对依据。阅读原图时应区分已展示的方法、拟验证的假设和最终结论,避免把流程目标当作实验结果。
推荐读图顺序
- 图1:工业大数据总体架构
- 图2:多源工业数据采集与治理
- 图3:数据平台存储与计算
- 图4:分析模型与服务层
- 图5:业务应用与决策闭环
逐图解读
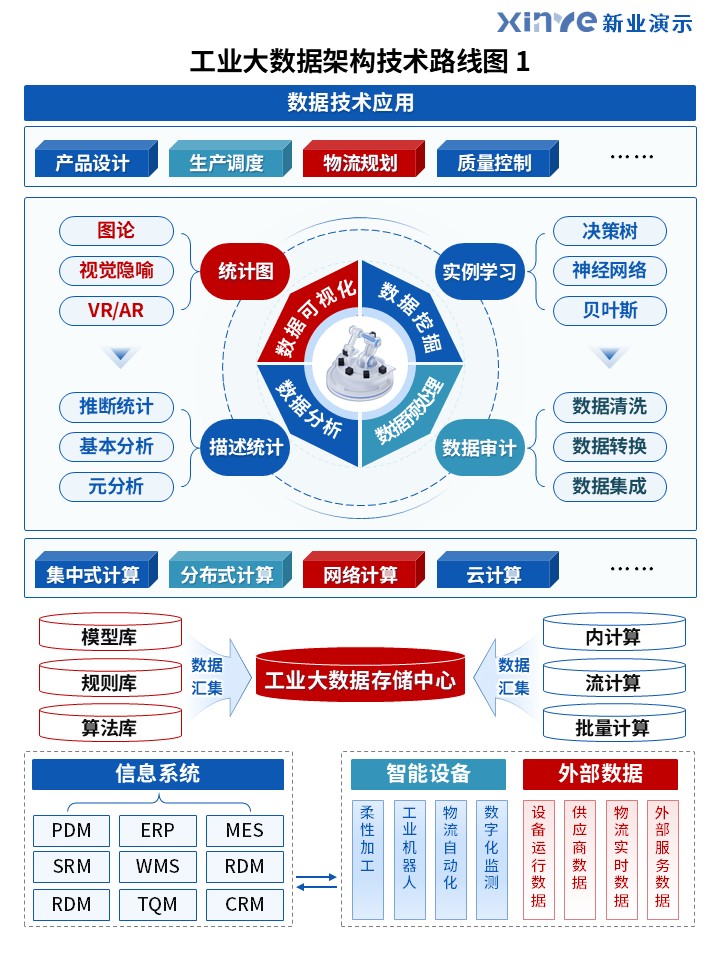
图1:工业大数据总体架构
本图以“工业大数据总体架构”为核心,重点查看工业数据采集和数据治理在研究流程中的位置。阅读时应区分输入数据、处理方法、输出结果和验证证据,并把箭头解释为具体的数据或条件传递。
衔接重点:完成“工业大数据总体架构”后,应记录可复核的中间结果,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间中与本图相关的指标核验,再进入下一研究模块。
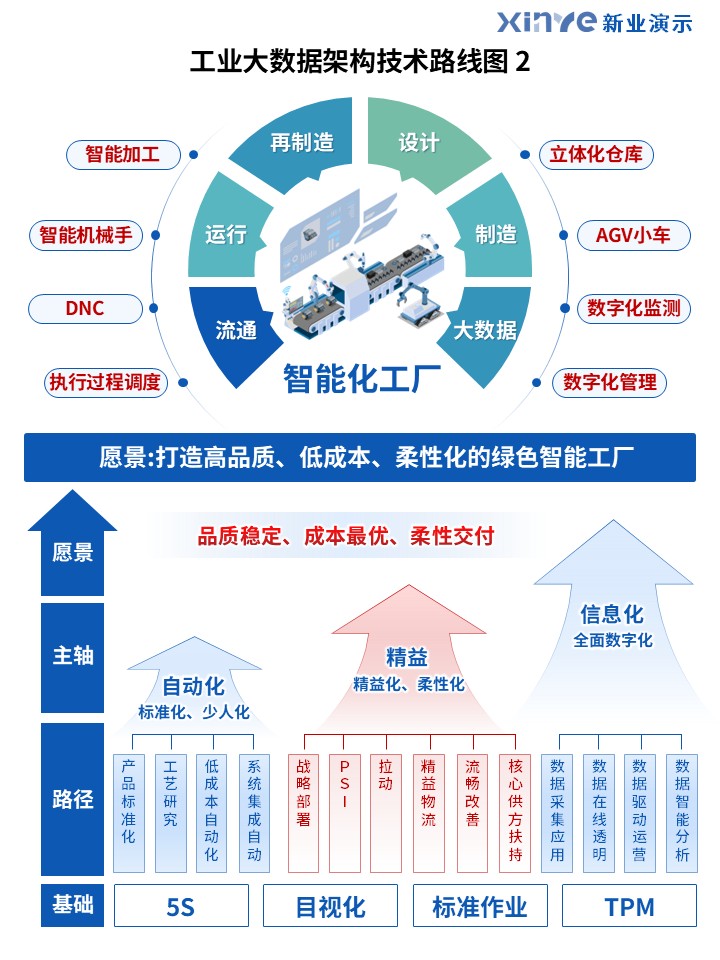
图2:多源工业数据采集与治理
本图以“多源工业数据采集与治理”为核心,重点查看数据治理和实时计算在研究流程中的位置。阅读时应区分输入数据、处理方法、输出结果和验证证据,并把箭头解释为具体的数据或条件传递。
衔接重点:完成“多源工业数据采集与治理”后,应记录可复核的中间结果,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间中与本图相关的指标核验,再进入下一研究模块。
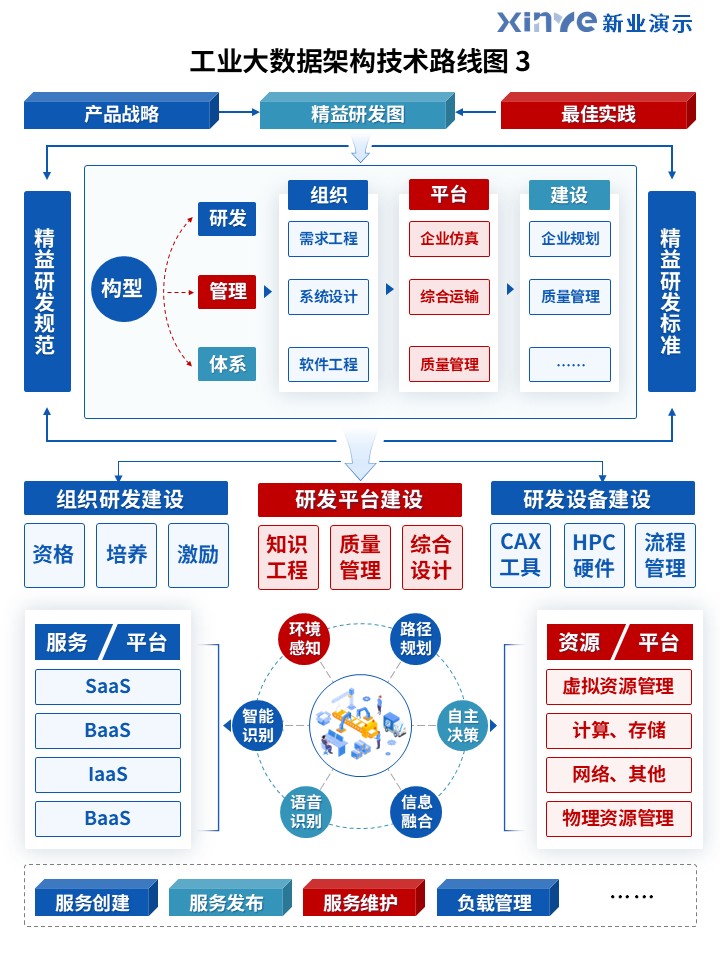
图3:数据平台存储与计算
本图以“数据平台存储与计算”为核心,重点查看实时计算和数据湖仓在研究流程中的位置。阅读时应区分输入数据、处理方法、输出结果和验证证据,并把箭头解释为具体的数据或条件传递。
衔接重点:完成“数据平台存储与计算”后,应记录可复核的中间结果,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间中与本图相关的指标核验,再进入下一研究模块。
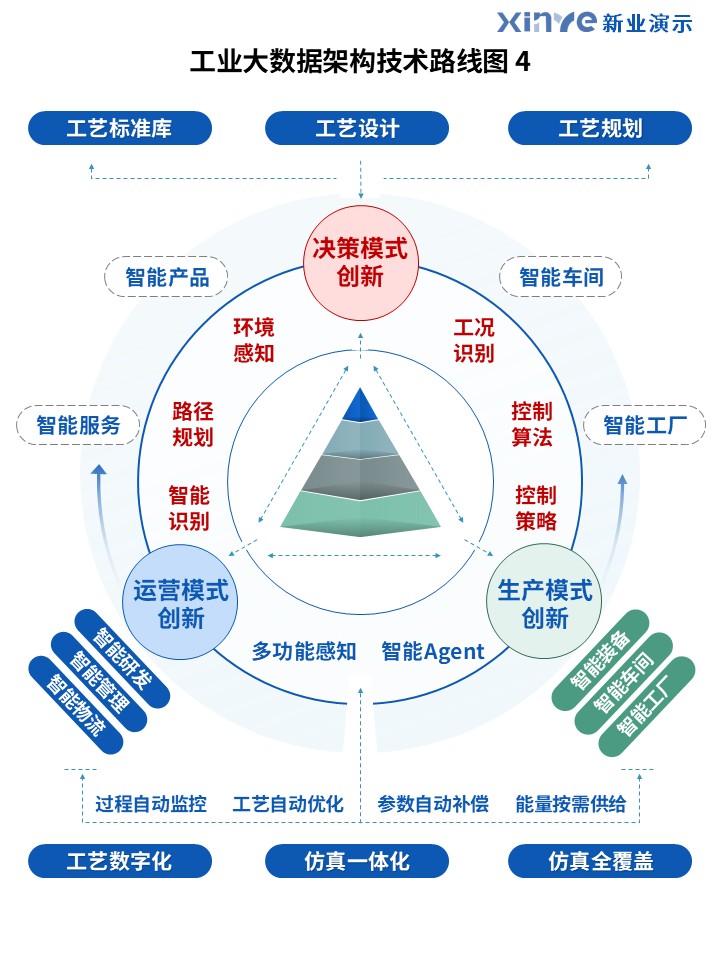
图4:分析模型与服务层
本图以“分析模型与服务层”为核心,重点查看数据湖仓和特征工程在研究流程中的位置。阅读时应区分输入数据、处理方法、输出结果和验证证据,并把箭头解释为具体的数据或条件传递。
衔接重点:完成“分析模型与服务层”后,应记录可复核的中间结果,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间中与本图相关的指标核验,再进入下一研究模块。
图5:业务应用与决策闭环
本图以“业务应用与决策闭环”为核心,重点查看特征工程和决策优化在研究流程中的位置。阅读时应区分输入数据、处理方法、输出结果和验证证据,并把箭头解释为具体的数据或条件传递。
衔接重点:完成“业务应用与决策闭环”后,应记录可复核的中间结果,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间中与本图相关的指标核验,再进入下一研究模块。
设计逻辑
如何复用到其他课题
- 保留问题—方法—证据—输出四层位置。
- 复用结构时,以工业数据采集、数据治理、实时计算、数据湖仓、特征工程等本课题真实对象和方法替换示例内容。
- 每个模块至少配置一个输入、一个输出和一个验证指标。
- 实线表示流程,双向箭头表示反馈,虚线表示待验证关系。
- 把预期目标改写为“拟验证、拟比较、拟评价”。
适用与不适用场景
适合
- 人工智能与计算课题申报
- 多模块研究方案汇报
- 需要展示证据闭环的技术路线
不适合直接套用
- 研究对象和原案例完全不同
- 缺少对照、基线或评价指标
- 直接把模板目标当作研究结论
图中术语解释
工业数据采集:界定研究对象和数据范围。数据治理:说明数据进入分析前的处理过程。实时计算:对应技术路线中的核心方法。数据湖仓:记录过程输出和验证证据。特征工程:用于与基线或对照方案比较。决策优化:明确结论成立的条件和适用边界。
常见问题
工业大数据架构科研技术路线图怎么画?(方案一)
先围绕工业大数据架构确定研究对象与核心问题,再按数据、方法、验证和输出四层组织结构。将工业数据采集、数据治理、实时计算、数据湖仓、特征工程、决策优化放入相应模块,每条箭头对应明确的数据或条件传递,并使用数据完整率、处理延迟、系统吞吐量、异常识别准确率和故障恢复时间核验研究闭环。
一套架构图需要多少张图?
通常可由1张总览图配合4—8张分模块图;若原始研究链较短,可合并模块,但不应删掉验证环节。
不同配色方案能否分别上线?
如果研究内容相同,只建议选择一个版本进入索引;其他配色版本保留为案例素材或设置合并审核,避免关键词内耗。
案例原图可以直接用于申报书吗?
可以参考结构,但必须根据自己的研究基础、技术条件和预期指标重新组织,并确认素材授权范围。
相关方法与模板
生成同类科研架构图
上传课题申报书或研究方案,辅助提取目标、模块关系和验证路径。
上传材料,生成科研架构图